Интервью с Артемом Вознюком о том, как AI меняет разработку игр
Семь лет назад в этой же рубрике мы общались с Артемом о том, что должен знать программист игр (Артем Вознюк о профессии Gameplay-программиста). Сегодня он каждый день работает с AI-моделями и разрабатывает собственный генератор ассетов, и смотрит на индустрию разработки игр уже снаружи. Мы поговорили о том, что за семь лет изменилось в профессии..
Небольшой дисклеймер от Артема
Сразу небольшой дисклеймер. Сейчас уже несколько лет в самой игровой индустрии я не работаю, хотя остаюсь где-то на стыке игр и AI. В последнее время я в основном работал в маленьких командах и стартапах.
Поэтому мои ответы здесь будут biased. Я не знаю, как прямо сейчас устроена работа в больших игровых компаниях и насколько быстро там всё меняется в связи с развитием AI. Но у меня самого за последние годы сформировалось довольно конкретное представление о том, как мне комфортно разрабатывать софт и куда, как мне кажется, всё это движется.
То, о чём я буду рассказывать, работает для меня и для небольших команд. Но я не уверен, что те же подходы в том же виде можно просто взять и перенести в Big Tech или в большую игровую компанию. Поэтому дальше будет мой личный опыт и то, как я сейчас себе представляю индустрию. Это не попытка рассказать, как правильно делать всем, а рассказ о том, как удобно делать мне.
Расскажи как изменился твой рабочий процесс за последние годы? Какой процент кода ты все ещё пишешь руками, а какой с помощью AI?
Изменилось практически всё. Изменения в самой игровой индустрии и IT-индустрии в целом для меня ещё перемножаются на изменения в моей собственной карьере. Раньше я был довольно широким специалистом внутри игровых движков, но по нынешним меркам это всё равно довольно узкая специализация. Сейчас я работаю, что называется, across the stack. Я всё ещё иногда касаюсь игровых движков, но в основном работаю с frontend, backend, инфраструктурой, ML inference, CI/CD, infrastructure as code, cloud — в общем, по всему стеку, без какой-то одной конкретной специализации.
Код руками я практически не пишу вообще уже где-то полтора года. Я даже не помню, когда последний раз написал руками целую функцию. Иногда могу что-то совсем локально поправить, переименовать, сделать какой-то мелкий рефакторинг, но в последнее время даже это обычно проще сказать агенту.
Причин несколько. Во-первых, если ты работаешь сразу по всему стеку, писать всё это руками просто слишком долго. Во-вторых, современные модели уже очень хорошо пишут код. Во многих вещах объективно лучше меня: они знают больше библиотек и API, не устают, не теряют концентрацию и часто знают какой-то подход, о котором ты просто еще не слышал.
Также важно, что мне это просто подходит по тому, как я всегда относился к программированию. Мне никогда особенно не нравилась сама механика написания кода: помнить конкретные API, сигнатуры функций, разбираться, как именно склеить две библиотеки. Мне всегда было интереснее понимать, как устроена система в целом: сети, операционные системы, игровые движки, инфраструктура, какие в ней есть компоненты и почему они взаимодействуют именно так.
Сейчас я на этом уровне работаю с агентами. Я должен понимать библиотеки, фреймворки и языки, которые они используют, чтобы увидеть, когда агент сделал что-то не то. Но разговариваю я с ним в основном на языке систем, требований и архитектуры, а не конкретной реализации.
Сам процесс у меня сейчас близок к spec-driven development. Я использую Claude Code и набор skills для него. Сначала я довольно абстрактно описываю, что хочу сделать. Потом отдельно прохожу с агентом grilling: он задаёт много вопросов про поведение системы, архитектуру, edge cases, ограничения. После этого всё превращается в spec, а spec — в конкретные GitHub Issues.
Дальше уже в отдельной сессии агент последовательно реализует эти тикеты. Он же пишет unit-тесты. Отдельно тестируются швы между системами — например, frontend/backend или разные backend-сервисы — с замоканными соседними компонентами. После реализации ещё один агент, уже без контекста агента, который писал код, делает отдельное code review. И что интересно, практически всегда находит один-два бага. Они исправляются, после этого код уже просматриваю я.
Расскажи о своем проекте.
Сейчас у меня два проекта. К одному из них я приступаю буквально на днях. Это контракт с американской креативной студией, которая занимается AI-маркетингом для крупных компаний, в том числе из Fortune 1000. У них есть большие клиентские проекты, где они сами делают рекламные кампании и используют в продакшене generative AI, и параллельно они строят SaaS для автоматизации генерации маркетингового контента. Я там тоже буду работать across the stack: DevOps, infrastructure, inference, full-stack разработка. Много про сам проект пока рассказать не могу, но технически там тоже довольно много visual generative AI, inference optimization и различных генеративных пайплайнов.
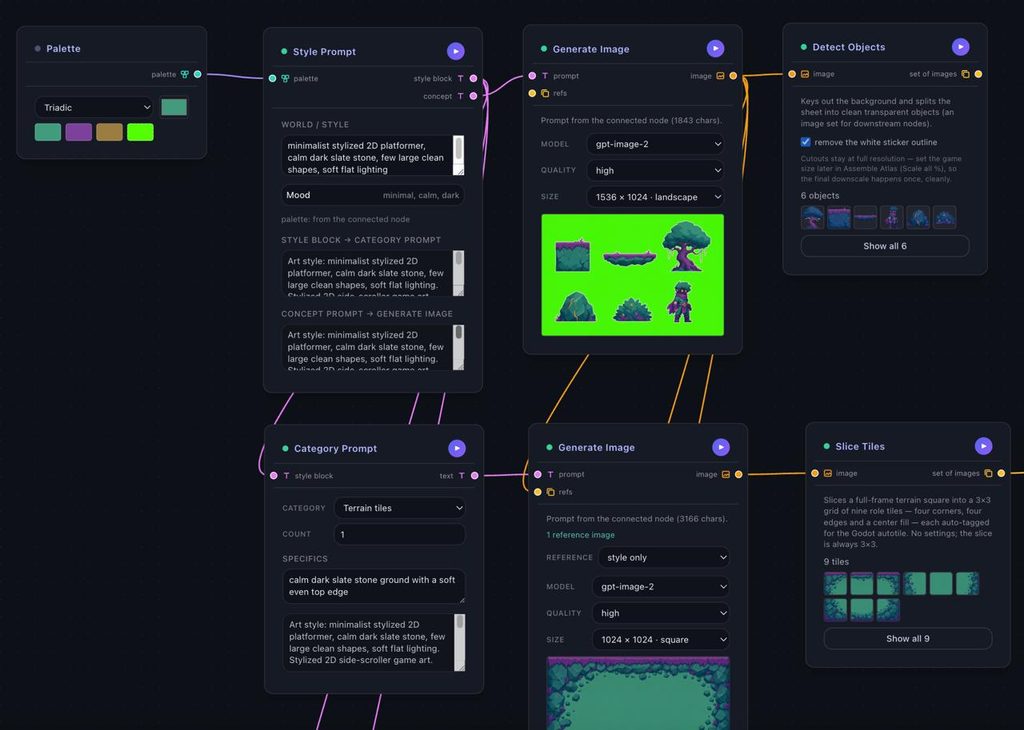
Второй проект — мой собственный, он называется imvimo. Это web-native платформа для разработчиков игр, которую я сейчас делаю соло. Проект пока находится на стадии R&D, и сейчас я в основном фокусируюсь на 2D-играх.
Идея появилась случайно. Я недавно впервые поиграл в Hollow Knight и Dead Cells. До этого как-то обходил такие игры стороной, а тут мне очень понравилось, насколько много атмосферы там создаётся именно за счёт 2D-арта. И мне стало интересно, насколько сложно самому собрать такую живую сцену в Godot или Unity.
И тут довольно быстро выяснилось, что между «модель умеет сгенерировать красивую картинку» и «у меня есть готовый ассет, который нормально работает в игре» пока огромная пропасть. Вокруг самих генеративных моделей приходится строить большие пайплайны из pre-processing и post-processing. Это особенно заметно, если тебе нужен не просто один красивый concept art, а, например, полный набор анимаций персонажа, props, parallax backgrounds, terrain, эффекты и всё остальное, что реально нужно для сцены.
Поэтому идея imvimo в том, чтобы сделать game engine agnostic веб-платформу, где такие ассеты можно не просто генерировать, но и сразу собирать и подготавливать для игры. А дальше должна быть тесная интеграция с конкретными движками, в первую очередь Godot и Unity.
То есть конечная цель не в том, чтобы нажать кнопку и получить PNG, который потом нужно нести в Photoshop или Krita, вручную резать, размечать, импортировать в движок и ещё там долго настраивать. В идеале ты нажимаешь кнопку в плагине и получаешь уже готовый игровой ассет: например, размеченный terrain с коллизией или персонажа с готовым паком анимаций. Сейчас я как раз экспериментирую с тем, насколько далеко такой подход вообще можно довести.
А как ты сохраняешь одинаковый визуальный стиль?
Пока это скорее область экспериментов, чем какая-то окончательно решённая задача. Сейчас у меня пайплайн примерно такой. Сначала генерируется цветовая палитра, которая становится одним из inputs для style prompt. В самом style prompt отдельно описываются art style, mood, формы, освещение и другие общие визуальные характеристики.
После этого по этому описанию генерируется своего рода reference image — несколько разных объектов, props и персонаж в одном стиле. И дальше уже при генерации конкретных ассетов — terrain, персонажей, props и так далее — я передаю модели не только текстовый style prompt, но и эту картинку как визуальный reference.
То есть идея в том, чтобы стиль не описывать заново для каждого ассета, а сначала один раз зафиксировать его текстом, палитрой и визуальным референсом, а затем переиспользовать всё это во всём пайплайне. Насколько далеко таким способом получится удерживать консистентность на большом количестве ассетов, это пока открытый вопрос.
Ты упомянул набор skills для Claude Code. Какие из них живут на уровне конкретного проекта, а какие универсальны для всех проектов? Упомянутый тобой «grilling» это тоже отдельный skill? Если есть публичный репозиторий и я, и читатели будут благодарны за ссылку.
Да, я использую довольно распространённый набор skills из репозитория Мэта Покока: https://github.com/mattpocock/skills. Он сейчас очень популярный, там уже больше 200 тысяч звёзд на GitHub.
Я использую несколько skills оттуда, немного модифицированных под свой процесс и конкретный проект. Они живут именно на уровне проекта, то есть находятся в репозитории вместе с кодом и становятся частью контекста, с которым работает Claude Code.
GitHub issues ты используешь как трекер и память чтобы claude code сам записывал задачи?
Да. Как раз некоторые skills из этого репозитория, например /to-spec и /to-tickets, используют информацию из контекста о том, какой issue tracker используется на проекте.
У меня практически всё построено вокруг GitHub: код, CI/CD, secrets, поэтому GitHub Issues я использую и как обычный трекер, и в каком-то смысле как память для агентов.
При этом более общий контекст проекта хранится прямо в репозитории, в папке docs. В CLAUDE.md у меня описана структура этой документации, поэтому агент понимает, какую информацию и куда имеет смысл сохранять. Например, законченные архитектурные решения могут оформляться как ADR. Отдельно есть directional-документы — туда можно записать, в каком направлении мы хотим двигаться по какой-то части проекта или фиче, когда окончательного архитектурного решения ещё нет.
После grilling агент собирает уже конкретный контекст задачи и через /to-spec превращает его в spec, которая сохраняется в GitHub Issue. Затем /to-tickets может взять эту spec, разбить её на более мелкие задачи и создать отдельные issues.
В итоге контекст не остаётся только внутри одной сессии с Claude Code. Более долгоживущие знания о проекте лежат в документации в репозитории, а конкретные задачи и спеки — в GitHub Issues. Поэтому новая сессия или другой агент могут довольно быстро восстановить нужный контекст и продолжить работу.
Расскажи про твою инфраструктуру: у тебя отдельные VDS для агентов? Или ты используешь docker-контейнеры, виртуальные машины?
Отдельных VDS именно для агентов у меня нет. Я использую обычный Claude Code: локальные сессии на моём Mac и иногда облачные сессии, но это всё равно Claude Code.
Если говорить про инфраструктуру самого проекта, то у меня отдельно существуют development и production environment. Для каждого из них есть свой VDS, на котором через Docker Compose деплоятся основные сервисы проекта.
Сами сервисы в основном занимаются оркестрацией генеративных пайплайнов, работой с очередью задач и базой данных. Основную базу данных я отдельно не хостю, для Postgres использую Supabase. А для inference open source моделей и различного post-processing, как на GPU, так и на CPU, использую Modal.
При этом managed-части тоже полностью разделены между development и production. То есть отдельная база, отдельные приложения в Modal, отдельная серверная инфраструктура. Агент работает в основном с development environment и уже через CLI и API получает доступ к тем частям инфраструктуры, которые ему нужны.
Что думаешь про индустрию? Какой твой прогноз, программисты станут не нужны?
Честно — не знаю. Но если нужно сделать ставку, то я бы сказал, что программисты в том виде, в котором они существовали несколько лет назад, скорее всего, действительно будут не нужны. В частности, мне кажется, что написание кода руками довольно скоро в основном уйдёт в прошлое. Просто потому, что само ручное написание кода — это очень большой bottleneck, который замедляет весь процесс разработки.
Думаю, вслед за этим будут довольно сильно меняться и сами процессы разработки. Сейчас быстрее всего это происходит в маленьких командах и стартапах, где проще полностью перестроить процесс. Но постепенно, мне кажется, это дойдёт и до больших компаний и Big Tech. Как конкретно там всё будет устроено пока не понятно.
Что мне при этом бросается в глаза в LinkedIn, X и вообще в разговорах вокруг AI — очень много людей в первую очередь думают о том, что они могут из-за всего этого потерять. Мне кажется, нужно больше внимания уделять тому, что мы, как специалисты, в связи с этими изменениями приобретаем.
Мне кажется, главное изменение здесь в том, что один разработчик теперь может гораздо быстрее заходить в незнакомые области и делать намного больше самостоятельно. Сначала LLM сильно упростили обучение: стало гораздо проще быстро разобраться в новой технологии, фреймворке или вообще другой части стека. С появлением агентов этот же подход перенёсся уже непосредственно в разработку — ты можешь не просто разобраться, а довольно быстро собрать работающую систему.
Поэтому я не люблю рассуждать об этом через вопрос “сколько рабочих мест исчезнет”. Риски здесь очевидно есть, и я не знаю, к чему в итоге придёт рынок. Но одновременно резко выросло количество вещей, которые один человек или маленькая команда вообще способны сделать. Если выбирать между более предсказуемой профессией программиста несколько лет назад и тем набором инструментов, который есть сейчас, я бы точно выбрал второе.
Есть у тебя правило, куда ты AI не пускаешь вообще? Какой код ты пишешь только руками и почему?
У меня граница проходит не по типу кода, а между development и production.
В development environment я, наоборот, стараюсь дать агентам максимально широкий доступ ко всему, что может понадобиться для работы: CLI-утилиты, MCP, базы данных, серверы, инфраструктура, managed GPU services и так далее. Практически каждый компонент системы у меня существует отдельно для development и production, поэтому агент может сам задеплоить изменения в development, проверить результат, посмотреть ошибки и продолжить работу.
При этом у агентов есть доступ к observability и для production. Я использую Sentry, Prometheus, Grafana, поэтому если, например, приходит alert, я могу сказать агенту посмотреть последние ошибки, разобраться, что произошло, исправить проблему и подготовить pull request. За счёт этого debugging и исправление багов сейчас тоже происходят очень быстро.
Но непосредственно к production у агентов доступа нет. Они не могут менять production-инфраструктуру, ходить в production database или каким-то другим способом работать с реальными пользовательскими данными.
То есть агент может получить столько контекста из production observability, сколько нужно для диагностики проблемы, но само исправление происходит в development. После того как всё проверено, я уже руками запускаю CI/CD pipeline, который раскатывает изменения в production.
Поэтому какого-то кода, который я принципиально пишу только руками, у меня нет. Ограничение для меня сейчас не в том, что AI можно или нельзя писать определённый код, а в том, какие реальные системы и данные ему можно дать менять.
Твои рекомендации в прошлом интервью (ССЫЛКА) были: C++, линейная алгебра, английский, «Game Engine Architecture». Что из этого списка ты бы вычеркнул сегодня, а что добавил?
Я бы ничего из того списка не вычёркивал. Потому что основной смысл тех рекомендаций был не в конкретных технологиях, а в том, чтобы учить фундамент.
Если говорить именно про игровую разработку, то C++, линейная алгебра и понимание того, как устроены игровые движки, всё ещё дают очень хорошую базу. Но сейчас я бы вообще шире смотрел на это правило: не учить конкретные команды Kubernetes, API какого-то фреймворка или очередную библиотеку, а пытаться понять, зачем эта вещь вообще появилась и какую проблему она решает.
Почему в сетях существуют разные протоколы. Почему в игровых движках из раза в раз появляются примерно одни и те же подсистемы. Зачем нужны threads и почему rendering и simulation часто разносят по разным потокам. Почему появились prefabs и Blueprints, а потом спустя годы индустрия снова начала активно двигаться в сторону ECS. Вот такие вопросы мне кажутся намного полезнее, чем просто знание конкретного инструмента.
При этом сейчас вообще лучшее время, чтобы этот фундамент изучать. Просто потому, что у тебя постоянно под рукой есть LLM, которой можно задавать сколько угодно тупых вопросов. Раньше ты читал техническую книгу, не понимал какой-то тезис и часто просто шел дальше. Сейчас можно остановиться и спросить: почему это так, покажи пример, а что будет, если сделать по-другому, как это устроено в Unreal или Unity.
“Game Engine Architecture” всё ещё отличная книга. Просто сейчас я бы читал её с LLM под рукой и разбирал всё, что осталось непонятным, сразу по ходу чтения.
Мне кажется, сейчас удобнее и полезнее всего учиться на практике. Если хочешь понять, например, что такое frontend и backend, можно взять Claude Code, собрать небольшой проект, а потом начать буквально допрашивать его по собственному коду: почему здесь сделано так, зачем нужен этот сервис, почему выбран такой API, почему здесь нужна база. У модели при этом уже есть весь контекст проекта, и по ощущениям это довольно похоже на обучение у разработчика, которому можно задавать вопросы в любой момент.
По поводу английского языка тоже ничего не изменилось. LLM сильно снизили языковой барьер, но сам язык никуда не делся. Код, документация, GitHub Issues, specs, architecture docs, communication внутри международных команд — всё это в основном всё равно на английском. Можно постоянно пользоваться переводом, но намного удобнее просто открыть документ и сразу понять, что там написано.
Но есть и обратный эффект: джун пишет промпт, получает работающее решение и на этом останавливается. Оценить, хорошее решение или плохое, он не может, а копать дальше нет причины, все же работает. Ты сам с этим сталкивался? Как бы ты организовал процесс менторинга?
С джунами всё действительно намного сложнее. И у меня здесь нет какого-то хорошего готового ответа. Я уже довольно давно работаю в командах, где все специалисты опытные, поэтому не буду изображать из себя эксперта по тому, как сейчас правильно менторить junior-разработчиков.
Но если меня заставить ответить на вопрос «что бы ты делал, если бы сейчас сам был джуном», я бы всё-таки вернулся к тому, о чём говорил выше: учил бы фундамент.
А ситуацию «написал prompt, получил работающее решение и пошёл дальше» я бы пытался в себе искоренять. Потому что главная опасность здесь не в том, что AI даст плохой код. Проблема в том, что ты при этом ничему не научишься.
Я бы старался специально воспитывать в себе любопытство. Выбрать несколько фундаментальных направлений в той области, которой занимаешься, и постоянно докапываться до того, как всё работает. Получил от агента решение — не останавливаться на том, что оно работает. Спросить: почему ты сделал именно так? Из каких частей это состоит? Какие здесь trade-offs? Как это можно было сделать по-другому? Почему другой вариант здесь хуже или лучше?
Причём не так важно, как именно это изучать. Можно читать книги и параллельно задавать вопросы LLM, можно идти от практики и разбирать вместе с ней код собственного проекта. Главное, особенно в начале карьеры, не отдавать модели сам процесс понимания.
Наверное, если бы я сейчас менторил джуна, я бы именно на этом и фокусировался. Не запрещал бы ему пользоваться AI и тем более не заставлял бы писать всё руками просто ради упражнения. Но постоянно просил бы объяснять собственное решение: что здесь происходит, почему оно устроено именно так и какие были альтернативы. Если человек может это нормально объяснить, то мне не важно кто физически напечатал код.
Ты делаешь генератор ассетов, а это как раз креативная составляющая, которую художники не хотят делать с помощью AI. Что, по-твоему, должно произойти, чтобы генеративный контент перестали воспринимать в штыки? Вырастет качество, появится прозрачность про датасеты, или это просто вопрос смены поколения?
У меня нет миссии переубедить людей, которые принципиально ненавидят generative AI. Сам imvimo появился из чистого любопытства. Я не умею рисовать, но мне стало интересно: что я могу сделать с современными инструментами, чтобы собрать красивую живую 2D-сцену с анимированными персонажами, даже если целую игру я в итоге никогда не сделаю.
Если из этого когда-нибудь получится коммерческий продукт, то я вижу его пользователей скорее как людей вроде меня, которым хочется что-то делать самим, но для этого не хватает каких-то конкретных навыков, либо как небольшие игровые команды, для которых скорость производства контента — это критичный вопрос.
Но чтобы такие инструменты стали нормальной частью разработки игр, действительно должно произойти несколько вещей. Самое очевидное — visual generative AI должен перестать быть технологической демкой и стать нормальным профессиональным инструментом. Сейчас есть большое количество стартапов на стыке AI и игр, которые разными способами делают примерно одно и то же: пользователь пишет prompt, а на выходе получается игра. Чаще всего это простая игра — Minecraft с машинками, Minecraft с пистолетами или простая аркада. Это прикольно прикольно само по себе, но профессионалу такой инструмент не нужен.
Я изучаю другой подход: не «напиши мне игру по промпту», а профессиональные инструменты внутри существующего production pipeline. Если художник или разработчик использует такой инструмент, на выходе должно получаться что-то профессионального качества, причём с достаточным уровнем контроля. Иначе смысла в нём немного.
Второй вопрос — это, конечно, датасеты, авторские права и вообще то, на чём эти модели обучались. Я прекрасно понимаю, почему эта тема вызывает такую реакцию у художников. Программисты находятся в похожей ситуации, хотя об этом реже говорят. Мы десятилетиями писали огромное количество кода, в том числе open source, а теперь этот код стал частью фундамента для моделей, которые автоматизируют нашу же работу. Недавний пост Сэма Альтмана, где он поблагодарил людей, которые писали сложный софт «character-by-character», как раз вызвал довольно сильную реакцию в духе «спасибо, что всё нам написали, дальше мы без вас». Поэтому я точно не думаю, что вопросы происхождения данных можно просто игнорировать и ждать, пока все привыкнут.
Но и к «смене поколения» я бы это не сводил. Мне кажется, скорее произойдёт постепенная нормализация самих инструментов. Когда-то Photoshop тоже очень сильно изменил работу с изображениями, сейчас никто не обсуждает сам факт его использования. С generative AI конфликт, конечно, намного сильнее, но если эти инструменты станут действительно удобными, контролируемыми и будут встроены в обычный workflow, думаю, со временем сам вопрос «использовал ли ты здесь AI?» станет менее интересным.
Плюс игры просто очень долго и дорого делать. Поэтому если AI действительно позволит маленькой команде делать за год то, на что раньше нужно было три года и в несколько раз больше людей, мне сложно представить, что индустрия в целом этим не воспользуется. Особенно если вся остальная IT-индустрия в это же время будет ускоряться за счёт автоматизации.
При этом я вполне могу представить отдельную нишу игр, где отсутствие generative AI будет частью ценности продукта. Что-то вроде handmade: «весь арт нарисован людьми, никакой генерации». И для какой-то аудитории это будет важно и круто. Но я не думаю, что таким останется весь рынок.
И я точно не думаю, что всё это в итоге означает «художники больше не нужны». Скорее хороший художник с действительно хорошими generative tools сможет делать намного больше, чем раньше. То есть в моём представлении конечная точка — не замена художника, а художник на стероидах.